Warum RAG allein nicht ausreicht
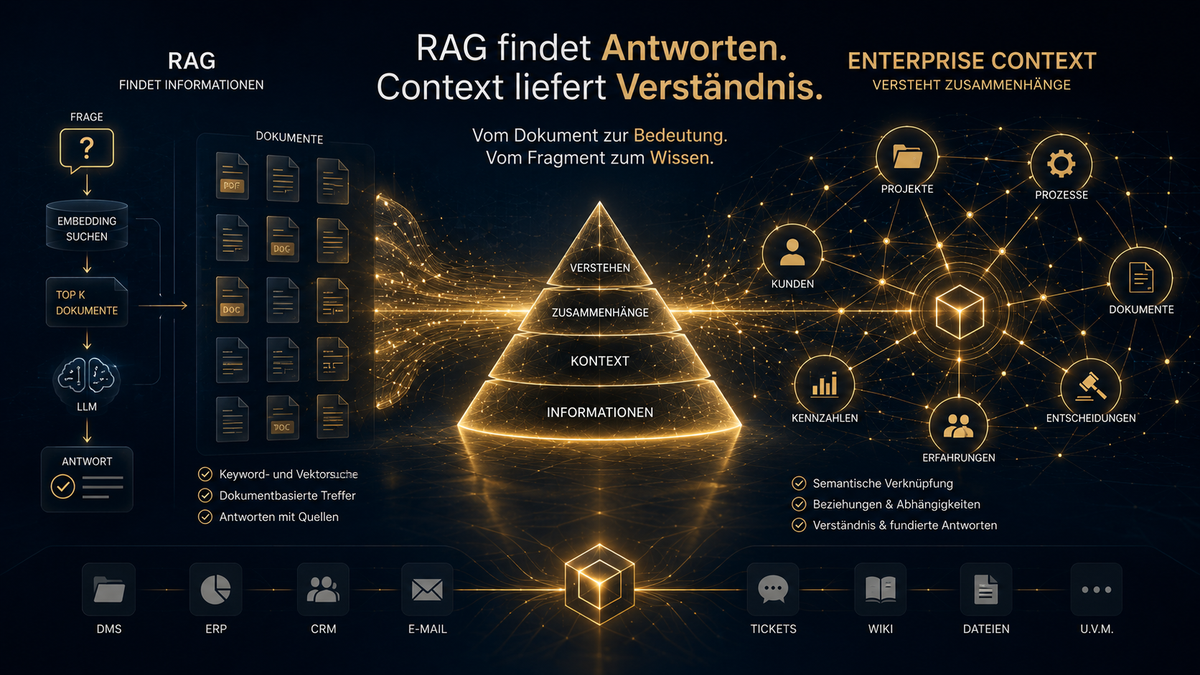
Retrieval-Augmented Generation verbessert den Zugriff auf Informationen erheblich — für ein belastbares Unternehmenswissenssystem reicht das allein jedoch nicht aus.
Artikelserie: Enterprise Context
Dieser Beitrag ist Teil einer fortlaufenden Artikelserie über Enterprise Context und intelligente Wissenssysteme.
Vorheriger Beitrag:
→ Was ist Enterprise Context?
Kaum ein Thema beschäftigt IT-Entscheider derzeit so sehr wie die Frage, wie sich unternehmenseigenes Wissen für KI-Systeme nutzbar machen lässt. Retrieval-Augmented Generation, kurz RAG, hat sich dabei als naheliegende Antwort etabliert — aus gutem Grund: Es macht interne Dokumente erstmals durchsuchbar für Sprachmodelle, die zuvor nichts über das eigene Unternehmen wussten. Trotzdem stoßen erstaunlich viele dieser Projekte an eine Grenze, die sich erst zeigt, wenn längst produktiv gearbeitet wird.
Wie das aussehen kann, zeigt ein Blick in den Alltag eines ganz gewöhnlichen Kundenservice.
Frau Bergmann hat gerade aufgelegt. Ein Anruf, wie es täglich Dutzende gibt: Ein Kunde möchte wissen, zu welchen Bedingungen sich seine Lieferung stornieren lässt. Sie öffnet den KI-Assistenten des Unternehmens, tippt die Frage ein, und Sekunden später erscheint eine klare, überzeugend formulierte Antwort — mit einem Verweis auf das zugrunde liegende Dokument. Sie liest sie dem Kunden vor. Er bedankt sich, zufrieden.
Zwei Tage später meldet sich derselbe Kunde erneut, diesmal verärgert. Die Bedingungen, die ihm genannt wurden, gelten seit über einem Jahr nicht mehr. Das Dokument, auf das sich die Antwort stützte, war nie aus dem System entfernt worden. Es lag einfach neben der aktuellen Fassung — unmarkiert, unauffällig, jederzeit auffindbar.
Frau Bergmann hat nichts falsch gemacht. Das System hat gefunden, was es finden sollte. Es hat nur nicht gewusst, dass es die falsche Version gefunden hat.
Ein Suchtreffer ist noch kein Unternehmenswissen.
Szenen wie diese häufen sich, seit viele Unternehmen RAG einsetzen, um ihre KI-Systeme mit internem Wissen zu verbinden. RAG liefert Treffer, zuverlässig und schnell. Ob diese Treffer aktuell, widerspruchsfrei und im richtigen Zusammenhang stehen, ist eine andere Frage — und genau hier beginnt das eigentliche Problem.
Was RAG leistet — und warum es sich durchgesetzt hat
Retrieval-Augmented Generation löst ein reales und wichtiges Problem: Sprachmodelle kennen von sich aus nur das, was in ihren Trainingsdaten enthalten war. Über die internen Dokumente, Prozesse oder Produkte eines bestimmten Unternehmens wissen sie nichts. RAG schließt diese Lücke. Vor jeder Antwort sucht das System zunächst passende Textabschnitte aus einer Unternehmensdatenbank und gibt sie dem Sprachmodell als zusätzlichen Kontext mit. Die Antwort entsteht dann nicht mehr allein aus dem Training des Modells, sondern auf Basis dessen, was tatsächlich gefunden wurde.
Kein Wunder, dass sich dieser Ansatz durchgesetzt hat. Er ist vergleichsweise einfach umzusetzen, reduziert offensichtlich erfundene Antworten, und er macht bestehende Dokumentbestände für KI-Systeme überhaupt erst nutzbar. Für viele Anwendungen — die schnelle Suche in einer Wissensdatenbank, die Beantwortung einzelner, klar abgegrenzter Fragen — ist RAG ein sinnvolles, oft ausreichendes Werkzeug. Die eigentliche Frage lautet also nicht, ob RAG funktioniert. Sie lautet: wofür.
Wo Trefferlisten an ihre Grenzen stoßen
Im Kern bleibt ein RAG-System eine Trefferliste mit einem sprachlich formulierten Vorschlag obendrauf. Es findet Textabschnitte, die einer Frage ähnlich sind, und lässt ein Sprachmodell daraus eine Antwort formulieren. Was es dabei nicht automatisch leistet: eine Bewertung, ob diese Textabschnitte inhaltlich zueinander passen, noch gültig sind — oder überhaupt die richtige Grundlage für eine Entscheidung darstellen.
Wenn Dokumente sich widersprechen
In gewachsenen Unternehmen existiert zu fast jedem Thema mehr als ein Dokument. Eine Preisliste aus dem Vertrieb, eine interne Kalkulationsgrundlage aus dem Controlling, eine Kundenvereinbarung aus dem Account-Management — sie können zum selben Sachverhalt unterschiedliche Aussagen treffen. Nicht, weil jemand einen Fehler gemacht hat, sondern weil sie zu unterschiedlichen Zeitpunkten für unterschiedliche Zwecke entstanden sind. Ein RAG-System, das mehrere solcher Dokumente findet, hat keine eingebaute Methode, um zu entscheiden, welches davon gerade maßgeblich ist. Es fasst zusammen, was es findet. Auch wenn sich die Fundstellen widersprechen.
Aktualität und Gültigkeit
Ähnlich verhält es sich mit der Zeit. Ein Dokument aus dem Jahr 2021 ist für ein RAG-System zunächst einmal ein Dokument wie jedes andere. Ob es durch eine neuere Version ersetzt wurde, ob es noch in Kraft ist oder ob es sich um einen veralteten Entwurf handelt, lässt sich allein aus dem Textinhalt oft nicht zuverlässig erkennen. Genau diese Information hat im Fall von Frau Bergmann gefehlt.
Ähnlichkeit ist nicht dasselbe wie Bedeutung
Der Grund dafür liegt tief in der Funktionsweise der Technologie. Die Suche in den meisten RAG-Systemen läuft über sogenannte Embeddings: Texte werden in einen mathematischen Raum übersetzt, in dem inhaltlich verwandte Texte nahe beieinanderliegen. Eine Anfrage wird in denselben Raum übersetzt, und das System sucht die nächstgelegenen Textabschnitte.
Ein leistungsfähiges Verfahren, um thematische Nähe zu erkennen. Kein Verfahren, um Bedeutung im eigentlichen Sinn zu verstehen. Zwei Textabschnitte können sprachlich ähnlich sein und trotzdem widersprüchliche Aussagen treffen. Zwei Textabschnitte können inhaltlich eng zusammenhängen, ohne dass sie sprachlich ähnlich formuliert sind — etwa, weil der eine ein Produkt beschreibt und der andere eine daraus resultierende vertragliche Verpflichtung. Ähnlichkeit im Embedding-Raum ist eine nützliche Annäherung an Relevanz. Sie ist kein Ersatz für ein Verständnis davon, wie Informationen tatsächlich zusammenhängen.
Was zwischen den Dokumenten fehlt
Die bisher beschriebenen Probleme haben einen gemeinsamen Nenner: Sie entstehen dort, wo etwas gebraucht wird, das nicht im einzelnen Dokument steht — sondern zwischen den Dokumenten, im Zusammenhang, in dem sie stehen.
Beziehungen und Zusammenhang
Unternehmenswissen existiert selten als isolierte Tatsache. Ein Kundenvertrag hängt mit einem bestimmten Projekt zusammen, das Projekt mit bestimmten Ansprechpartnern, die Ansprechpartner mit Entscheidungen, die an anderer Stelle dokumentiert sind. Diese Beziehungen sind für ein sinnvolles Verständnis oft wichtiger als der einzelne Text selbst — und ein RAG-System, das jeden Textabschnitt isoliert behandelt, kann sie nicht abbilden. Sie stehen in keinem der gefundenen Abschnitte allein.
Quellen und Nachvollziehbarkeit
Wenn ein System eine Antwort liefert, ist für den Menschen, der sie liest, oft ebenso wichtig, woher diese Antwort stammt, wie die Antwort selbst. Stammt sie aus einer verbindlichen internen Richtlinie oder aus einer informellen Notiz? Wurde sie von der zuständigen Fachabteilung geprüft? Diese Nachvollziehbarkeit von KI-Antworten — die Möglichkeit, eine Aussage bis zu ihrer Quelle zurückzuverfolgen — geht über das reine Auffinden ähnlicher Textabschnitte hinaus. Sie muss explizit modelliert werden.
Berechtigungen und Governance
Nicht jede Information darf jeder Person angezeigt werden. Personalunterlagen, vertrauliche Vertragsdetails, interne Bewertungen unterliegen üblicherweise klaren Zugriffsregeln. Ein RAG-System, das seinen Suchindex ohne Rücksicht auf diese Regeln aufbaut, kann vertrauliche Informationen ungewollt offenlegen. Governance — wer worauf zugreifen darf und wie das nachvollziehbar geregelt ist — lässt sich nicht nachträglich auf ein Retrieval-System aufsetzen, ohne die zugrunde liegende Struktur der Daten zu verstehen.
Erfahrungswissen, das nirgends dokumentiert ist
Ein erheblicher Teil des Wissens, das ein Unternehmen erfolgreich macht, existiert nie als Dokument. Es steckt in den Erfahrungen einzelner Mitarbeitender, in ungeschriebenen Regeln, in Entscheidungen, die mündlich getroffen und nie protokolliert wurden. Retrieval kann nur finden, was vorher geschrieben wurde. Erfahrungswissen entsteht nicht dadurch, dass mehr Dokumente durchsucht werden. Es muss aktiv erfasst und in einen Zusammenhang gebracht werden, der über einzelne Texte hinausgeht.
Der Unterschied zwischen Retrieval und Kontext
Retrieval beantwortet die Frage: Welche Textabschnitte sind zu dieser Anfrage ähnlich? Kontext beantwortet eine andere Frage: Was muss ich über die Organisation, die Beziehungen, die Gültigkeit, die Herkunft und die Berechtigungen wissen, um diese Information richtig einzuordnen?
Die erste Frage lässt sich mit vertretbarem Aufwand technisch lösen — das haben RAG-Systeme in den letzten Jahren eindrücklich gezeigt. Die zweite Frage erfordert etwas anderes: eine Struktur, die Dokumente, Daten, Prozesse und Erfahrungswissen nicht nur auffindbar macht, sondern sie zueinander in Beziehung setzt, mit Herkunft und Gültigkeit versieht und Zugriffsregeln von Anfang an mitdenkt. Genau an diesem Punkt beginnt das, was viele Unternehmen inzwischen als Enterprise Context bezeichnen — dazu gleich mehr.
Enterprise Context: die fehlende Schicht
Für diese zweite, weiterreichende Aufgabe hat sich der Begriff Enterprise Context etabliert: die organisatorische Wissensschicht, die Dokumente, Daten, Prozesse und Erfahrungswissen in einen nachvollziehbaren Zusammenhang bringt — mit Beziehungen, Governance, Herkunft und Berechtigungen als integralem Bestandteil, nicht als nachträglicher Ergänzung.
Retrieval-Augmented Generation bleibt dabei ein wertvoller Baustein. RAG ist ein Werkzeug. Kein Wissenssystem. Es sucht und liefert Textabschnitte zuverlässig — ob diese Textabschnitte im richtigen Zusammenhang stehen, beantwortet erst der Enterprise Context darüber.
Was Enterprise Context als Konzept genau umfasst und warum es sich als eigenständige Kategorie von klassischen KI-Werkzeugen abgrenzen lässt, ist Thema des nächsten Artikels dieser Serie.
Frau Bergmanns Kunde hat sein Geld am Ende zurückbekommen. Der Imageschaden blieb trotzdem — nicht, weil ihr System zu wenig gefunden hätte, sondern weil es nicht wusste, was es gefunden hatte.
Ein Suchtreffer ist noch kein Unternehmenswissen. Genau deshalb endet Enterprise Context nicht beim Finden von Informationen — sondern beginnt dort, wo Retrieval aufhört. Wer verstehen will, wie sich dieser Unterschied in der Praxis auflösen lässt, findet im nächsten Beitrag dieser Serie eine genauere Einordnung von Enterprise Context als eigenständigem Konzept.
Weiterlesen
Vorheriger Beitrag
Nächster Beitrag
→ Vom Dokument zum Wissenssystem (erscheint in Kürze)
Artikelserie: Enterprise Context
Diese Veröffentlichung ist Teil einer fortlaufenden Artikelserie über Enterprise Context und intelligente Wissenssysteme.
- Informationen sind überall. Kontext fast nirgends.
- Was ist Enterprise Context?
- Warum RAG allein nicht ausreicht
- Vom Dokument zum Wissenssystem
- Warum Wissensgraphen wieder wichtig werden
- Das STARE Framework
- Die Architektur intelligenter Organisationen

